
Lifelong Learning,可以简称LL,所以我也是拉拉人
¿
1. 终生学习
终生学习(Lifelong Learning),叫法比较多,像持续学习的说法可能更常见些(但是我不管这些)。终生学习更像是这一领域的终极目标,让一个模型活到老学到老。
2. 深度学习的通病
人会遗忘,机器也不能免俗。一个训练好的模型,其适用范围往往受限,学会了认水果,但不会认动物。但模型也是会举一反三的,仰仗已经学会的知识,模型很快就能学会辨认动物。这个过程研究下来就是如今的迁移学习。
然而这模型很是一根筋,学完辨认动物你刚要夸它呢,转头一看它已经不会认水果了。你问为什么,模型也有话说了,这可是你给它的指导思想:模型只管以最快的速度,往当前任务表现最好的地方冲就完事了。模型一听就乐了:
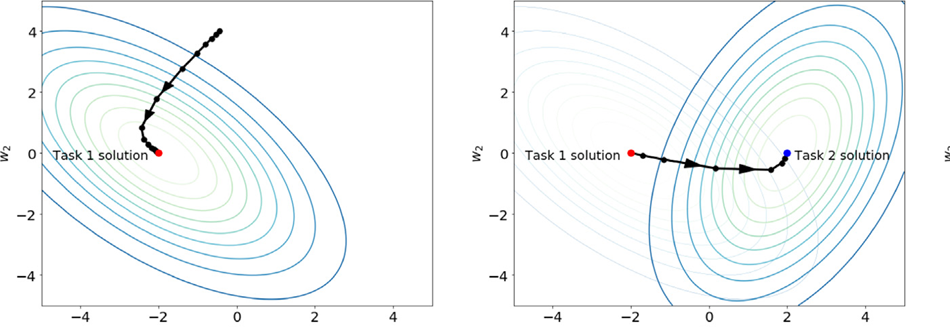
很明显,数学成绩好往往不代表语文成绩好,而考前临时抱佛脚只看语文,数学又忘得一干二净。一根筋的模型+简单粗暴的指导思想带来的这个问题,我们一般称为模型发生了灾难性遗忘(Catastrophic Forgetting)。学术一点地说就是:一个模型学会新任务后,在旧任务上出现表现急剧下降的情况。
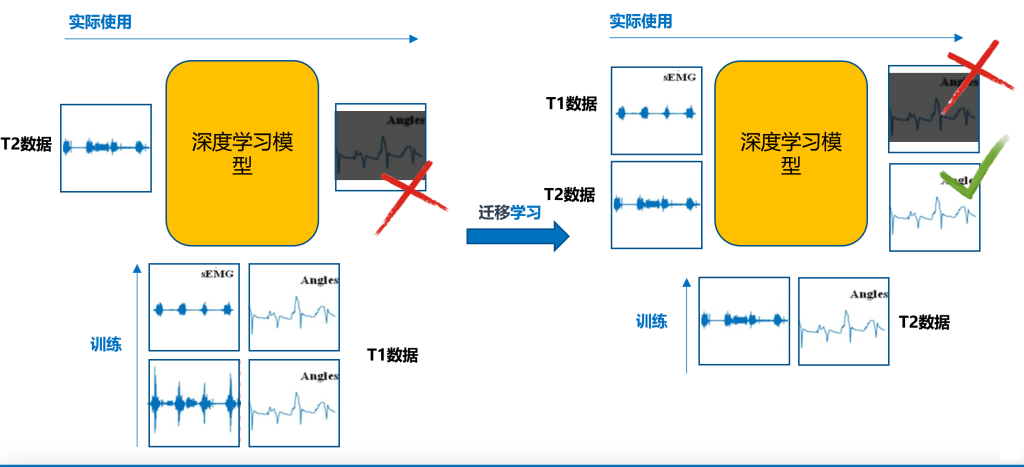
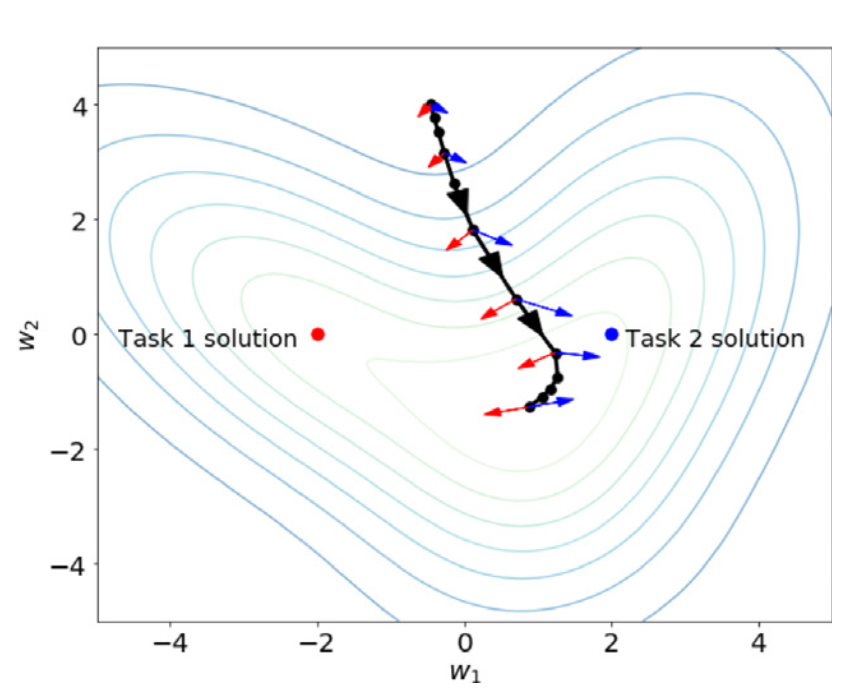
灾难性遗忘出现的一个原因往往是因为不同的数据集间分布往往有很大不同,故模型在一个任务上表现最好的点,往往在其他任务上表现很差。而另一个原因就是观察到数据的时间维度的不同,如果能同时观察到两部分数据,那么这个问题就一转多任务学习。
题外提一句,为什么同时观察到多个数据集的多任务学习上模型的效果比较好呢, 这得益于任务数据间的“拔河”(tug-of-war)平衡,最后达到了一个妥协和折中的最佳点。
3. 终生学习场景
3.1 终生学习模式
在正式说明前,还是需要给终生学习解决的问题抽象一下。一个模型m,我们希望它能学会任务T1-Tn,但是这n个任务的数据不是同时给到的,而是按时间顺序给到模型让模型学习,称之为一个任务序列。为便于理解此处假设数据是按任务分割,不同的任务间数据无重合,每个数据集不会包括一个以上得到任务所需的数据,数据/任务到来的顺序就按1-n排列。而且开始训练第k个任务的时候,前面k-1个任务的数据就再也获取不到了。
终生学习算法应当不受任务到来顺序的影响,对任务顺序的相关研究参考课程学习(curriculum learning)的领域。
3.2 终生学习的评估
在3.1的模式下,我们有几种评估的指标,此处仅做简单文字描述与动机说明,因为它的计算方式五花八门,只要言之有理。
一套经典的计算方式来自GEM的论文文献。
- 模型的总体准确率:“年终考核”,最直接的评估,模型始终要学完这n各任务,那我们一定会评估模型在这n个任务上的总体表现。一种经典计算就是模型学完全部任务后,验证其在全部n个任务上的平均准确率。
- 后向迁移能力(Backward Transfer):“巩固反思”,评估模型学习了新的任务后,在旧任务上能有多少收益。现今阶段大多方法,这个收益一般为负,此时BT可以等同于评估模型的记忆能力。
- 前向迁移能力(Forward Transfer):“举一反三”,评估模型学习新的任务时,能从已学习的旧任务上获取多少收益,可以等价于对迁移学习的期望评估。
4. 终生学习方法
要解决任务,就要具有任务相应的知识,就像一个冰箱,装肉就能完成提供肉的任务,装菜就能完成提供菜的任务。那么终生学习的几类经典方法就很好理解了,此处提到的方法不做具体细节介绍。值得一提的是,终生学习的分类是比较众说纷纭和边界模糊的,理解思想就好,命名不重要。
终生学习是妥协的艺术
(到最后还是人妥协了……)
4.1 基于梯度的方法
要想一个冰箱既能提供肉又能提供菜——这不是显而易见的,又装肉又装菜就完了。基于梯度的方法最根本上干的就是这么个事。根据旧模型计算,我们会得出一些梯度上的辅助信息,作为“限制”/“约束“,让模型往新任务最佳点走的同时,尽量离旧任务们都近些。
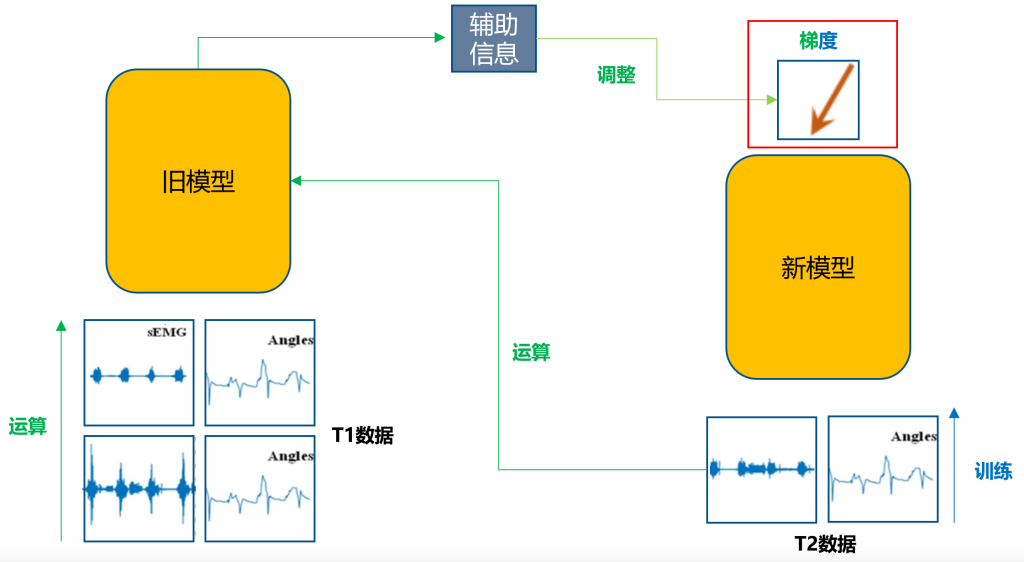
这类方法下,除了最直击本质的实现(如GEM,EWC外),现今使用最多的是和知识蒸馏联动,经典的代表是Learning without Forgetting(LwF)。
而这类方法的一些问题也显而易见了。
- 又装肉,又装菜——只是两方都装了,两方都装的少。都行很多情况下也代表都不行,基于梯度的方法就是模型内部做出的妥协。
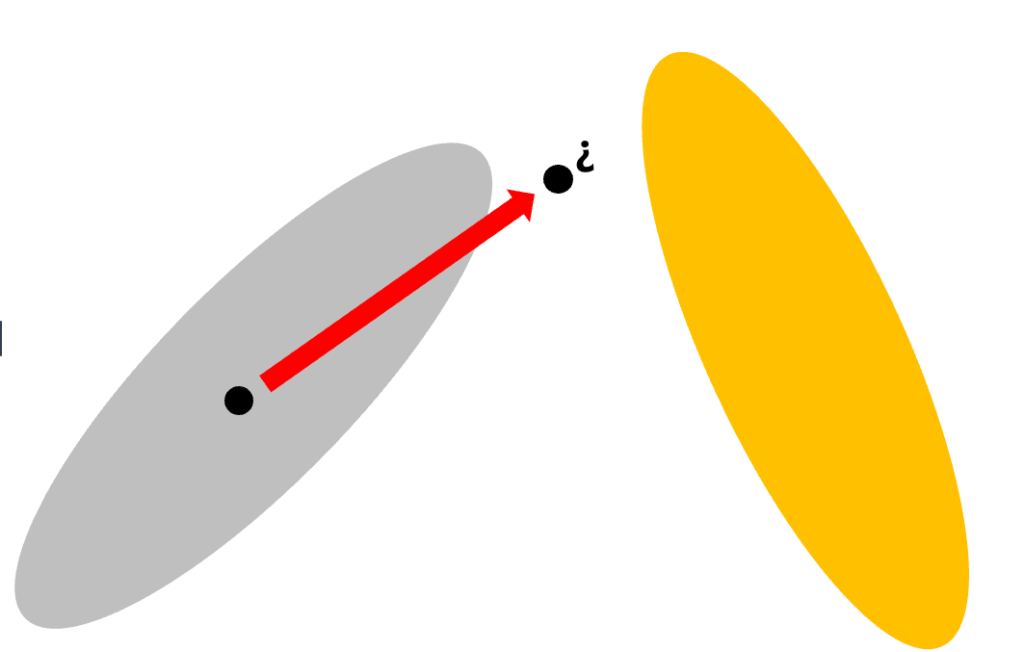
- 另一个问题,还记得上面的梯度图吗,两块区域还是有重叠的,若任务数据间的分布进一步扩大到足够大,这类方法最后达到“都不行”的情况就会明显到模型无法使用。至此方法失效。
- 模型内部的知识承载量是有限的,随着学习任务增加,很快就会陷入遗忘或拒绝学习的两难境地,巧妇难为无米之炊。
4.2 模块化的方法
模块化大致又分两种,外部的模块化和内部的模块化。
4.2.1 外部的模块化
要想冰箱又能提供肉又能提供菜,有没有其他的办法?当然有,我们再买一台冰箱和旧的并排一放,一台装肉,一台装菜。简单粗暴,现在的模型能力不够了?那我们就加参数,而且最开始的工作,真就是“加一整台冰箱”的最粗暴的阐释——渐进神经网络(PNN),它就是直接加一整套参数实现的。
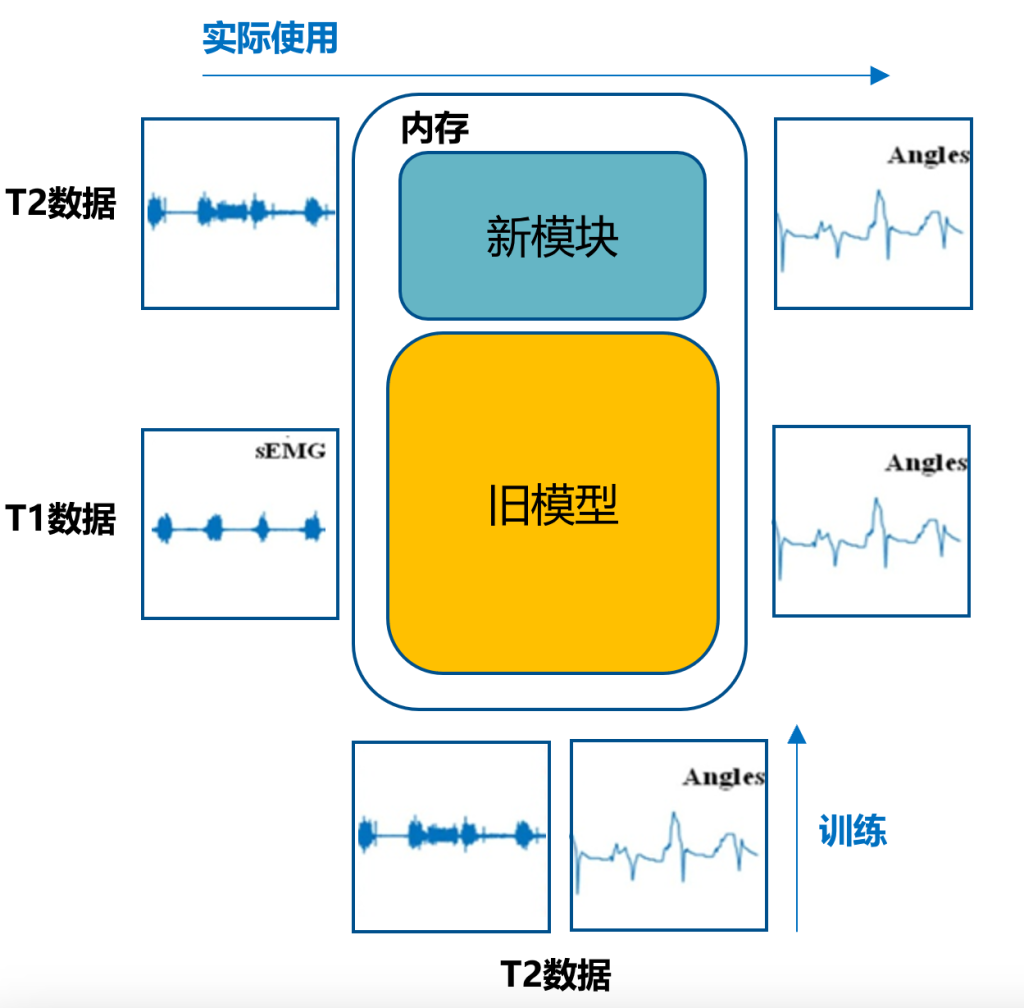
那么缺陷也显而易见,加一台整的冰箱不要地方放,不要钱的?加一层就解决的事,怎么直接买了一台回来?当然后来大家也意识到了这点,所以大家提倡:能少加就少加,加一部分能解决就不要这么大费周章。外部模块化实际上就是设备能力(内存/算力)向模型能力的妥协。
4.2.2 内部模块化
往一个杂乱的仓库里再放东西,感觉放不下了,不可能大手一挥直接加一座仓库,怎么办?一般将仓库整理一下,分门别类,往往发现又能放下了,内部模块化本质就是对内部进行分门别类和做整理的思想。
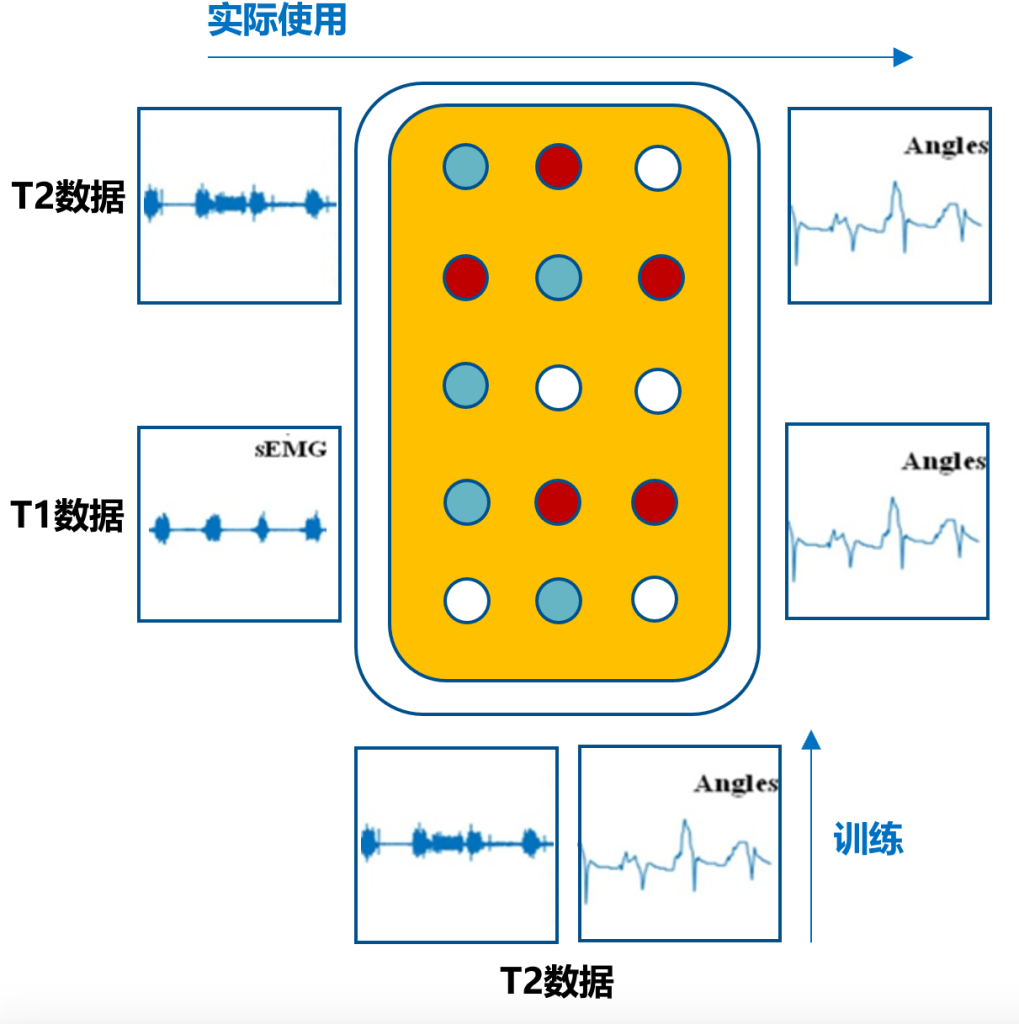
在模型中,一个个神经元的参数就是一个个知识的仓库,选择一个神经元只学习固定的任务,从而从内部对知识的存储空间进行分割,这就是内部模块化的本质。而到现在,这类思想更多被称为稀疏化(Sparsity)的方法。它的逻辑本质与基于梯度的方法是一样的,都是模型在内部做出的妥协。那么方法面临的问题也就是很类似的。
4.3 基于记忆的方法
考前突击语文忘记了数学,有没有办法再把数学学习回来呢,但是数学课已经过了。“这还不简单,复习啊”。没错,数学课虽然已经过了,但我们有课程的录像,更多的我们有自己记的笔记。没错,这种很朴素的思想就是基于记忆的方法,本质上就是把观察到的数据,通过一些方式保存下来,等到后续训练的时候,将保存的数据和新的数据一起进行训练,将终生学习的任务转化为多任务学习的任务。
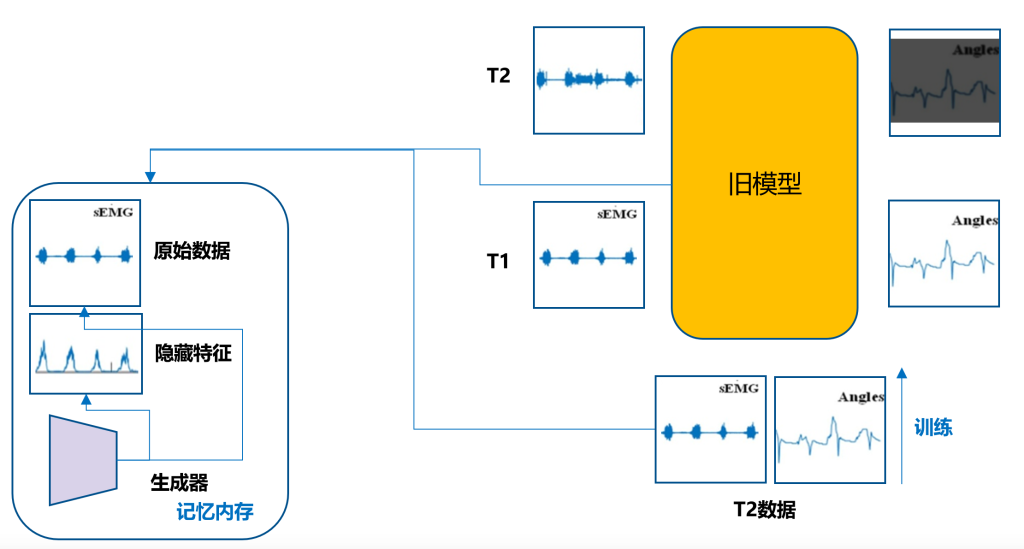
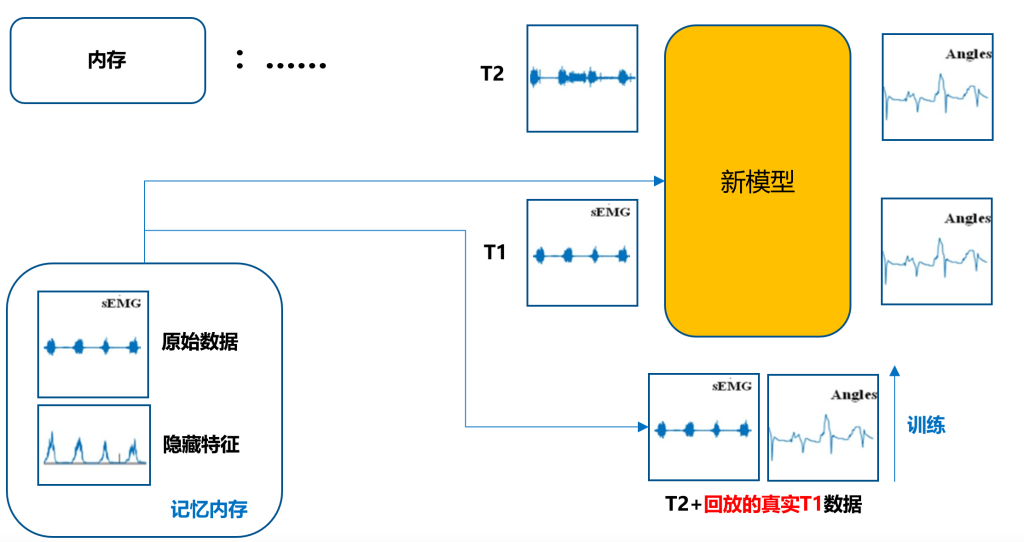
可回放的手段多种多样,比如原始数据(课程录像),高层次特征(自己做的笔记)。进一步有训练生成器来在训练新任务时生成旧数据。这类思想的本质其实还是和基于梯度的方法是一样的,那就是去调整梯度的方向,只是从认为进行梯度方向的调整,转变为让数据来自行决定。
你看别人自己Tug-of-War搞得挺好的吗,你去插手干嘛呢?
从另一个角度看,基于记忆的方法就是消除问题情景中无法再观察到旧数据的限制,算是一种“作弊”的手段。那么代价是什么呢?还是内存/算力,基于记忆的方法本质上还是设备能力向模型能力的妥协。
那么其问题也显而易见了:
- 设备的内存与算力是有限的,特别是在边缘设备上。这些设备资源往往是“昂贵”的。
- Tug-of-War也是有极限的,参考基于梯度的方法中,两数据分布相差太大的情况。
- 特别地,针对基于生成器的方法,生成器生成的数据质量无法保障,在像生成生理信号这样信息量和冗余程度比较高的方法时,
我的评价是一坨这类方法缺少数据复杂度的考验。
当然,即使这样,这种“作弊”的手段使得模型的记忆尺度超过了前两大类的方法,是个人觉得最有效的一类办法。
5. 终生学习的发展方向
前述分类的基本方法里,仔细观察发现大多数考虑的是知识的存储问题,解决的都是如何存储更多种类的知识。它们很多都陷入了思维上的盲区——即它们都是让一个模型用所有的知识,去解决一个特定的问题。打比方,就像你在数学考试的时候,想导数题怎么做的时候还默默去过了一遍早上背的古诗。
不要只学会存储知识
还要学会怎样使用
而在稀疏化的发展过程中,逐渐对知识选择有了更多的关注。来看一个例子:Hard Attention Mask。
5.1 Hard Attention
一提到attention,本质就是一个加权和打分的模块。Hard attention在我看来就是二极管的打分——也就是选择。
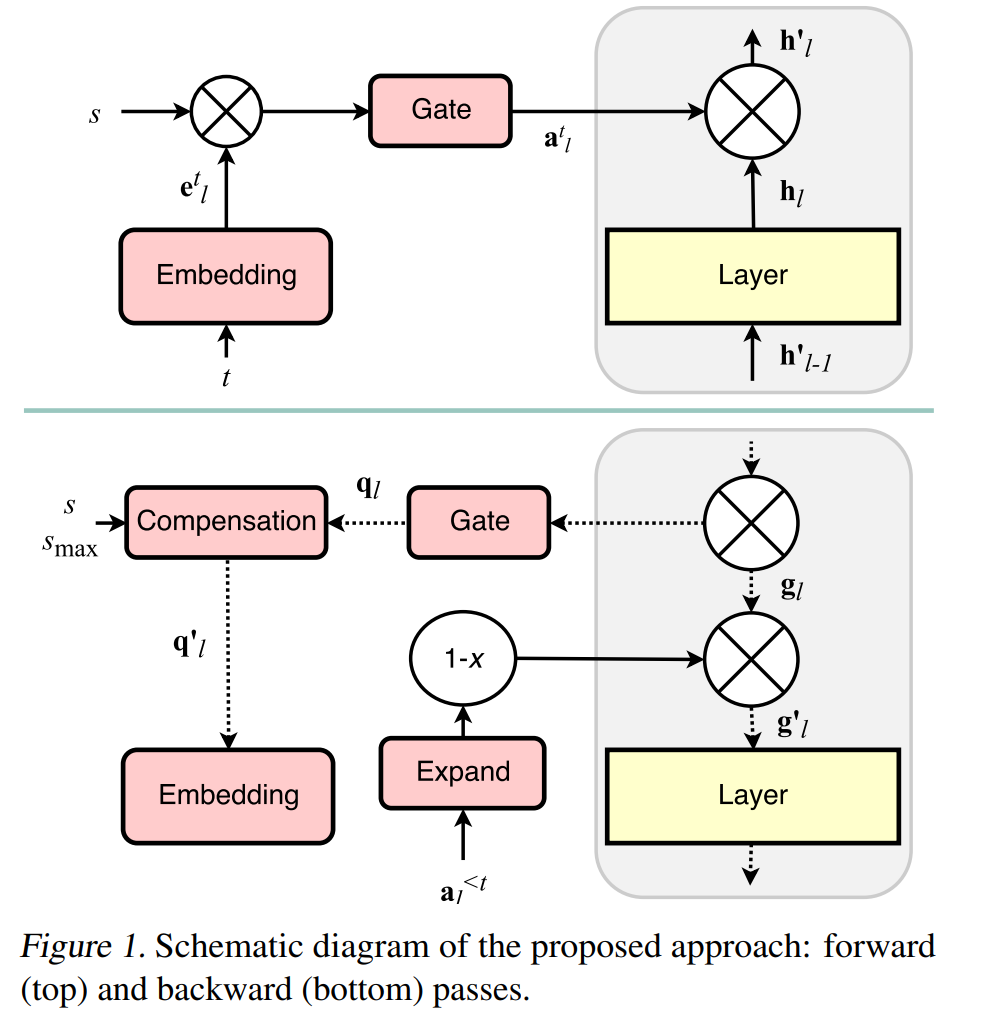
以前向传播为例,选择过程以task的标签作为输入为开始,将task进行嵌入,与辅助信息s与任务嵌入Embedding做乘法再通过一个Gate function(这里是sigmoid)生成Hard attention的mask。该mask为二元硬编码,即非0即1,将它与前序模型输出的feature map进行对应元素乘(element-wise),与0相乘的部分便达到了屏蔽某些神经元参数的效果,达到了选择部分神经元对特定任务进行运算的效果,进一步,即实现了对知识的选择。
该方法在学习与推理时都以知识选择为重点,但经典方法中探索的知识存储也不能落下。两相结合,我们来看下一个例子:Adapting BERT
5.2 Continual Learning Adapter
在Adapting BERT一文中,作者团队修改了传统用于迁移学习的Adapter结构。将简单的线性—非线性—线性的结构进行改变。原来的线性—非线性—线性结构作为一个基础单位(胶囊网络),给每一个任务添加一个胶囊用于存储特定知识,然后添加KCL层提取知识的维度,最后提取到共享的知识池,然后就由我们的老同志Hard Attention Mask对知识做出选择生成最后的输出。
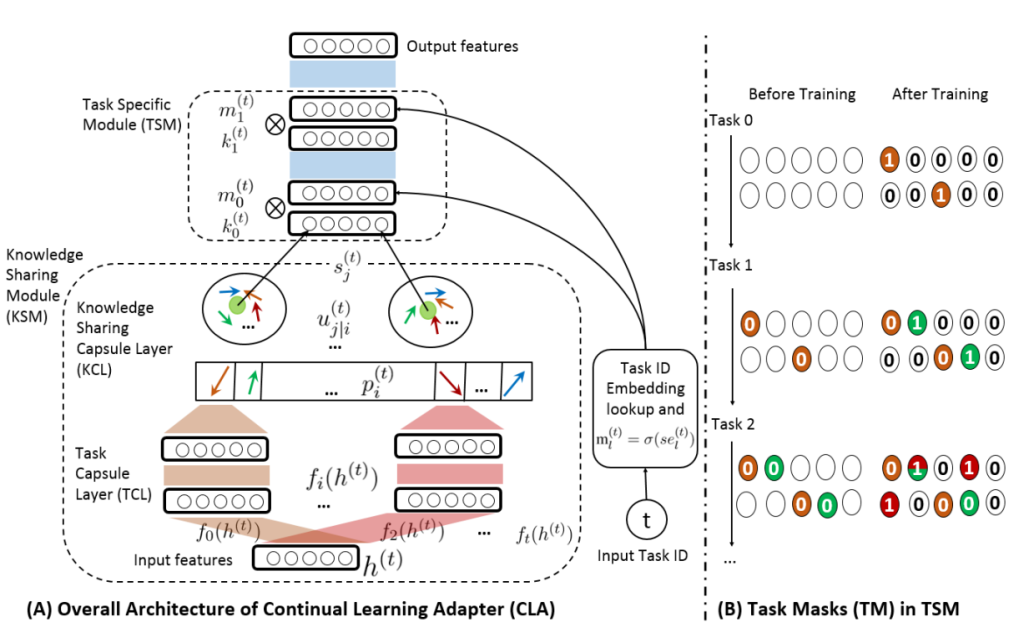
这是一个抽象的过程,让我们用具体的例子来尝试说明:现在我们想搞推销,我们就要学习——面对不同的人我们应该如何使用话术将产品推销出去。
我们向人推销时:
- 我们有给多个人做完推销的经历(训练时数据的输入)
- 对每个人的推销过程与推销结果我们都总结了经验(分配了胶囊网络进行了学习)
- 然后我们对经验进行了总结,并总结出了几个知识维度,如对年龄,性别,性格,对每个特征的不同,我们的话术会有不同偏向(通过KCL生成了共享知识池)
- 最后我们在向一位新客户推销时(在陌生数据上进行推理),我们根据新客户对知识维度进行筛选,比如我们这位新客户是年轻20多岁的一位文静的女性(使用Task mask进行知识筛选)
- 最后根据我们对新客户的定位和学习到的知识,我们就生成了最后的话术偏向(output feature),最后由这个话术偏向最后生成推销话术,最后大幅提高了推销成功的概率。
由此可见该方法真正比较全面地体现了构建了一个知识存储+知识筛选的体系。
5.2 More and More EFFICIENT
我们可以回到第四节回顾一下我们是如何存储更多的知识的,抛开不扩容的方法不谈,我们都是拿模型参数和内存来存储知识的(当然,参数扩张最后还是反应到内存上)。这样的扩充方法再怎样效率实在还是有限,看看现在的大模型就知道了。实际应用我们可以“土豪”,但在理论上,我们始终都是要假定自己“贫穷”的。所以如今的终生学习,要的就是更加高效的知识存储+更加高效的知识选择。
摸鱼,爽!
建设中……
Comments NOTHING